《Learning to Refuse》和《MUSEG》论文阅读
问题与创新
问题发掘:在传统VTG任务中,数据集常常是一个视频,一段查询,输出一个查询对应的视频片段。研究者们致力于提升模型预测正确的概率,为此提出了不少方式。但是把思路放宽,我们考虑如下情况,现实生活中给出随机一个视频,任意一个查询,可能出现的情况有:1、视频中有且只有一个对应文本查询的片段;2、视频中没有对应文本查询的片段;3、视频中有多个对应文本查询的片段。这三种情况加起来才是更为全面的。对于1而言,也就是传统VTG领域大家都在做的,那么2与3,分别对应的就是《Learning to Refuse》与《MUSEG》所应对的情况。
创新点由来:
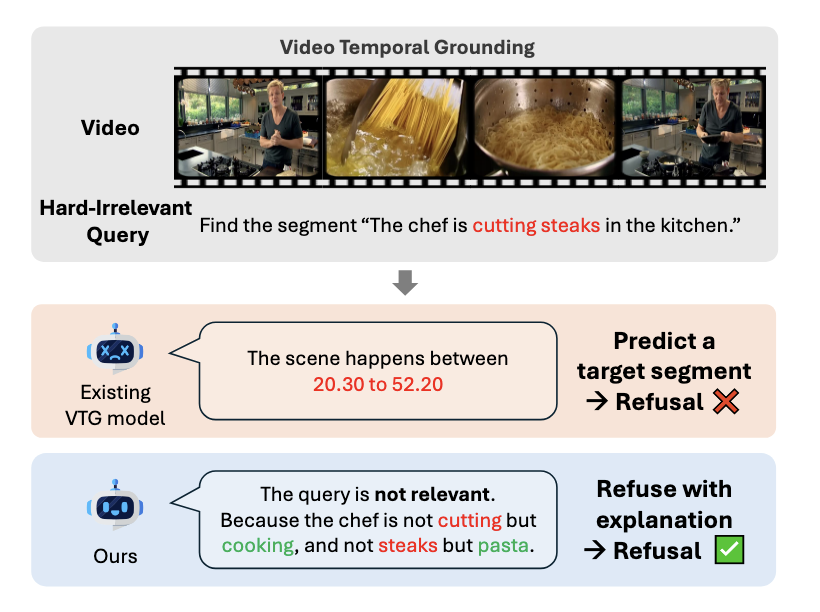
《Learning to Refuse》作者应是先注意到视频中可能根本不存在文本查询,然后查阅了相关的资料,发现做这个方向的研究主要有两条路,一是基于训练的方法,也就是通过将无关查询与视频通过训练的方式让模型学会拒绝完全不相干的查询,而是基于大模型的方法,也就是通过大模型的泛化能力自主拒绝回答不相关查询。作者继续发掘现状,虽然已经有拒绝完全不相关查询的工作了,但是如果将正确查询只修改一小部分,这种错误查询非常考验模型的细粒度,当前的工作就无法解决了。于是基于这种查询,作者称之为Hard-Irrelevant Query,作者提出自己的强化学习微调方式:RA-RFT。我们可以通过图1这个例子,简单了解一下所谓Hard-Irrelevant Query是什么。
原理介绍
《Learning to Refuse》方法介绍
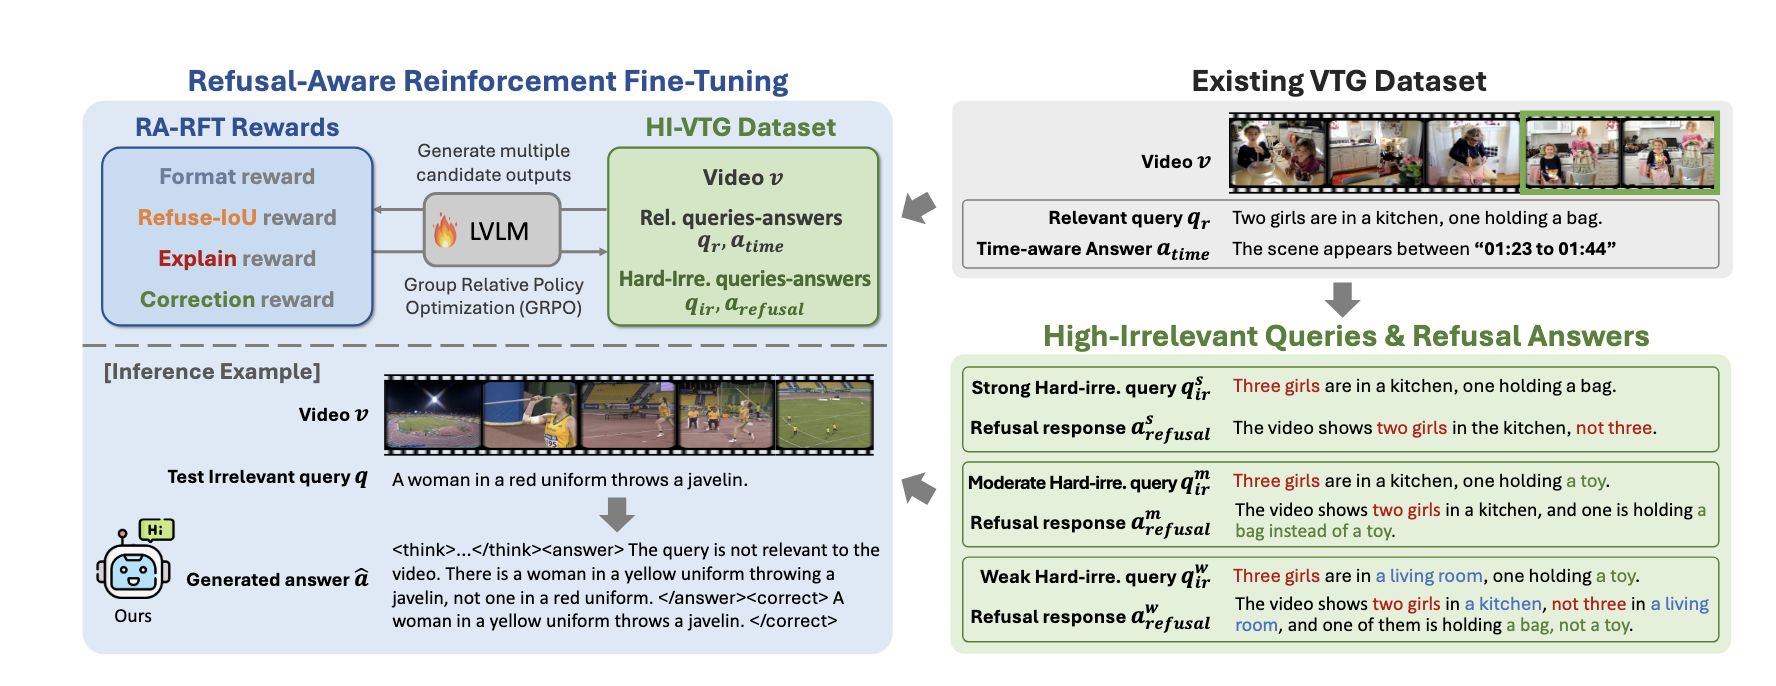
要看懂本文,只需要看懂图2即可。先看到右上角的VTG Dataset,这是常规的VTG数据集,有视频,有查询qr,也有真实时间atime,而作者设计的数据则会加上右下方这一部分,可以看到将原本的查询修改一个部分生成的查询被作者称为Strong Hard-irre. query,也就是最高难度的不相关查询,而修改两部分原始查询得到的查询就是Moderate Hard-irre. query,也就是中等难度,以此类推。与修改查询相关的,作者还会给出Refusal response,也就是模型的拒答回复。这样设计数据的原因是先要训练模型遇到这种困难不相关查询时能够拒绝回答,然后给出解释为什么拒绝回答,最后能够给出修正查询。
数据集的基本设计就如上所说,再看到左边,接下来就要设计奖励函数了。我们用左下角的例子来看懂作者的意图:左下角的视频内容是一名身穿黄色制服的女子在投掷标枪,查询中写的是身穿红色制服的女子在投掷标枪,明显可以看出这是高难度的不相关查询,那么作者希望模型如何回复呢,我们看到模型生成回答这里,首先模型的回答遵循一定的格式,也就是
接着作者想要当查询正确的时候,奖励模型输出符合Ground Truth的时间回复,当查询错误的时候,模型应该拒绝回答,如下公式:
当查询正确,用IoU衡量时间预测正确的重叠程度,当查询错误,给出拒绝回答奖励1,除了以上两种情况都不给奖励。
接着作者想要模型给出合适的解释,当查询正确时,解释应该是时间戳而非拒答回复,于是apos取atime,aneg取arefusal,用语义相似度使答案趋向时间而非拒答回复;当查询错误时,同理。
最后,当查询错误时,作者想要模型给出修正查询,通过上述公式,通过语义相似度的方式,使查询错误时候的修正回复能趋向于原始正确查询。
《MUSEG》方法介绍
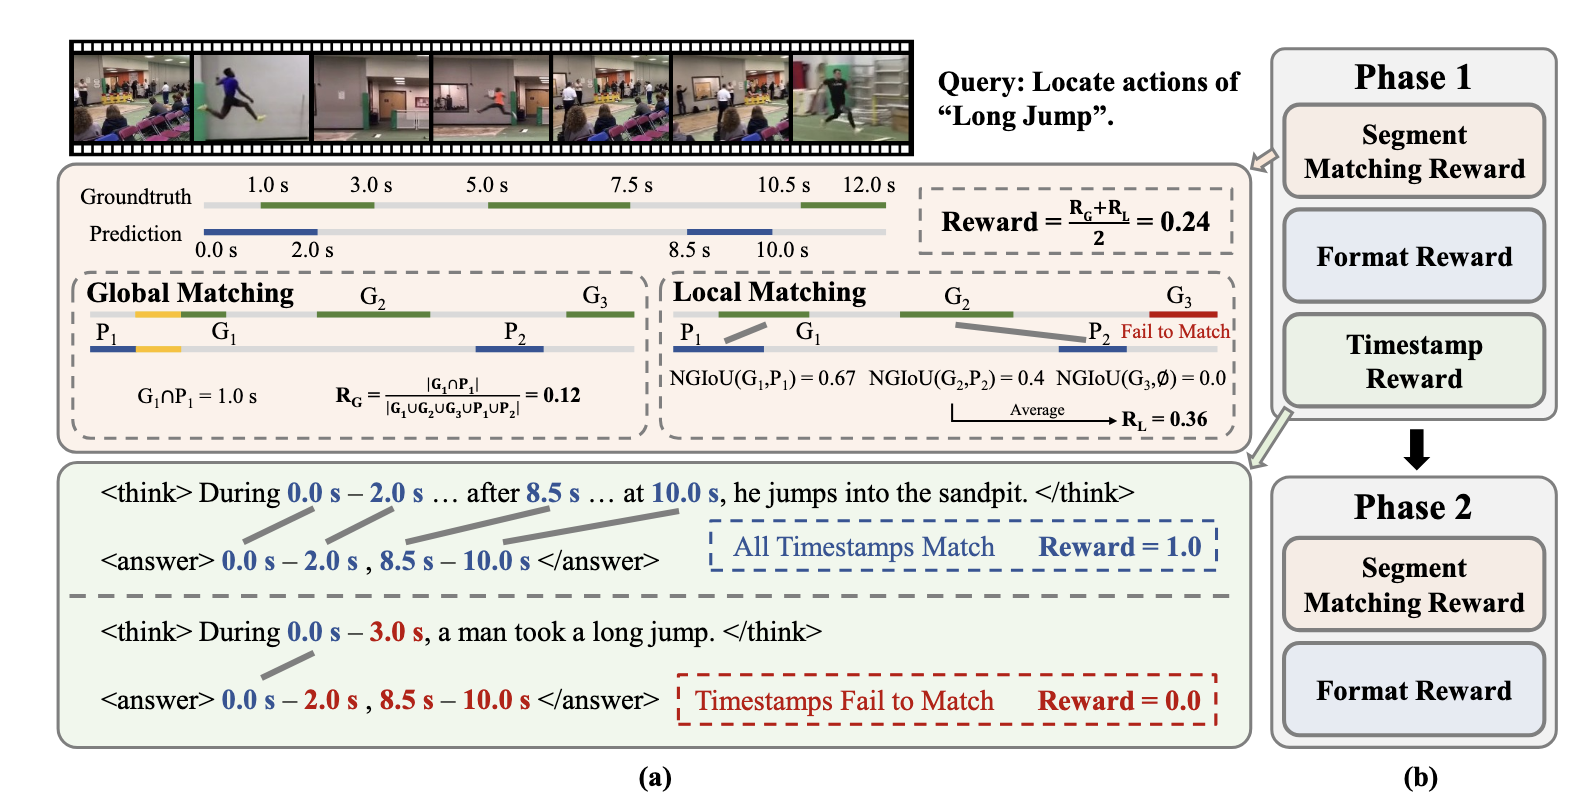
仍然一张图讲解全文。本文聚焦于多段,时间戳,分阶段,只要抓住这三个点,就能抓住全文的脉络。作者训练模型用了900轮(为什么,没为什么,问就是测出来的),前四百轮采用阶段一训练,后五百轮采用阶段二训练,阶段一有三个奖励,从上到下分别是多片段匹配奖励(很好理解,我们想要模型预测的多个片段尽量符合Ground Truth),格式奖励(这个说过了,RL基操),时间戳奖励(神奇的设计,后面具体讲),二阶段有两个奖励,其实也就是在一阶段的基础上删去了时间戳奖励(问就是测出来效果好)。
下面具体分析几种奖励方式:
这四条公式对应图的左上角的多片段匹配奖励,第一条公式是全局匹配奖励,也是最常规的IoU,只不过是把一个视频片段的IoU改成多个片段,本质没有变,第二条公式是局部匹配奖励,具体操作如图所示,将GT和模型预测的片段按顺序匹配(第一条匹配第一条,第二条匹配第二条),这时候有人会问,如果GT有三个片段,模型只预测了后两个片段而且预测效果不错,也按照顺序匹配吗,那不是将原本正确的匹配打乱错排了吗?是的,作者在后文也测试了这种直觉上合适的匹配方法,也就是最大匹配,测出来效果没有顺序匹配好,所以问就是测出来的。关于局部匹配奖励的设计,除了顺序匹配以外,奖励函数也由原本的IoU改为GIoU,简单来说就是,在GT与模型预测完全无法匹配的时候,IoU只能显示为0,而GIoU对完全不重叠的两个片段仍然能评判是不是离的更远,这样有利于模型存在梯度从而利于训练,对于GIoU是什么,可以看一下文末附录。第三第四条公式就是做了两个平均,将全局匹配奖励和局部匹配奖励进行了加权融合而已。
上式是时间戳奖励,其实非常简单,只要模型的CoT中出现答案预测的所有时间戳,那就奖励1,否则0。因为模型是自回归的,作者认为这种方式可以让思维链加入时间戳,从而让答案更加准确。我之所以说这是神奇的设计,是因为CoT这种东西,有人说利用他加强了模型性能,能让模型更加理解时间的含义,从而作为创新点发表;又有人说CoT没啥用,去掉还增加效率,以此作为创新点发表。这篇文章更加神奇的点就是,前400轮用,后500轮不用,这还不够神奇吗。
最后是格式奖励,没有什么可讲的。这篇论文的不少设计都有点先射箭后画靶的感觉,训练轮次不必说,还有分阶段训练,时间戳奖励,顺序局部匹配方式······,不过能把箭射出来,也是大家梦寐以求的本事了。
小结
- 看了这两篇论文之后,感觉可发掘的东西肯定还是有的,虽然这两篇论文要求的计算资源都很高,要全量复现不太现实,不过或许可以从其他角度去发掘创新点。
- 本文在撰写过程中发现插入下标还不太方便,之后应该会对此做一个调整。
附录
GIoU个人解释:GIoU相比于IoU就是增加了一个惩罚项,当预测与GT没有任何重叠的时候,IoU都会是0,但GIoU能告诉算法哪个更接近目标。惩罚项的构成就是用既不属于预测又不属于GT的时间除以他们的并集,所以如果两段区间有交集,那么惩罚项就为0.所谓NGIoU就是将GIoU从【-1,1】投影到【0,1】
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
