《How Should Video LLMs Output Time? 》论文阅读
问题与创新
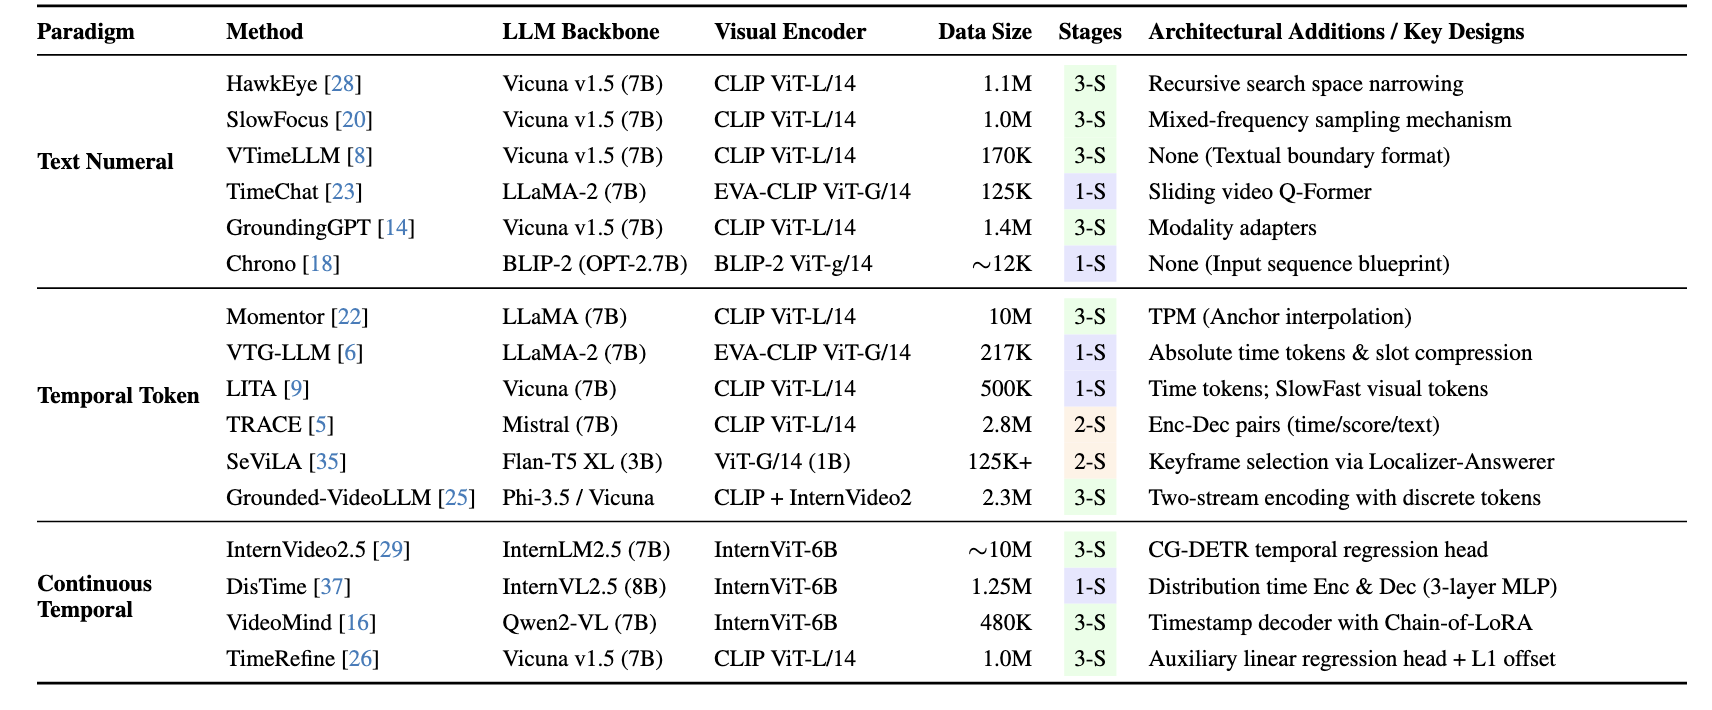
在当前的基于大模型的VTG工作中,已经存在多种不同的输出方式,其中具有代表性的是三种输出方式:Text Numeral Generation(文本数字生成)、Temporal Token Generation(时间token编码)、Continuous Temporal Decoding(连续时间解码)。
然而,将它们直接进行对比是不现实的,不同的论文方法采用不同的backbone、数据、协议······直接对比无法看出三种方式在各种情况下对模型性能的影响。因而当下缺乏受控实验对它们进行对比,从这一点入手,作者提出了本文的设计思路。
创新点:作者设计了受控的实证研究,比较了主要的三种VTG输出范式。作者采用三种backbone,每种中设计不同的参数量,SmolVLM2(0.5B与2.2B)、FastVLM-1.5B、Molmo2(4B与8B),并且在三种不同的数据集上进行了测试Charades-STA, QVHighlights, and YouCook2,最终比较结果的性能、效率与计算成本。
相关工作
本文中涉及到的三种输出方式采用了其他论文中的风格,比如文本数字生成就采用了VTimeLLM-Style,时间token编码采用了TRACE-Style,连续时间解码采用了DisTime-Style。我们之前阅读过的VTG-LLM其实也是属于时间token编码的,附下图。
原理介绍
总体框架
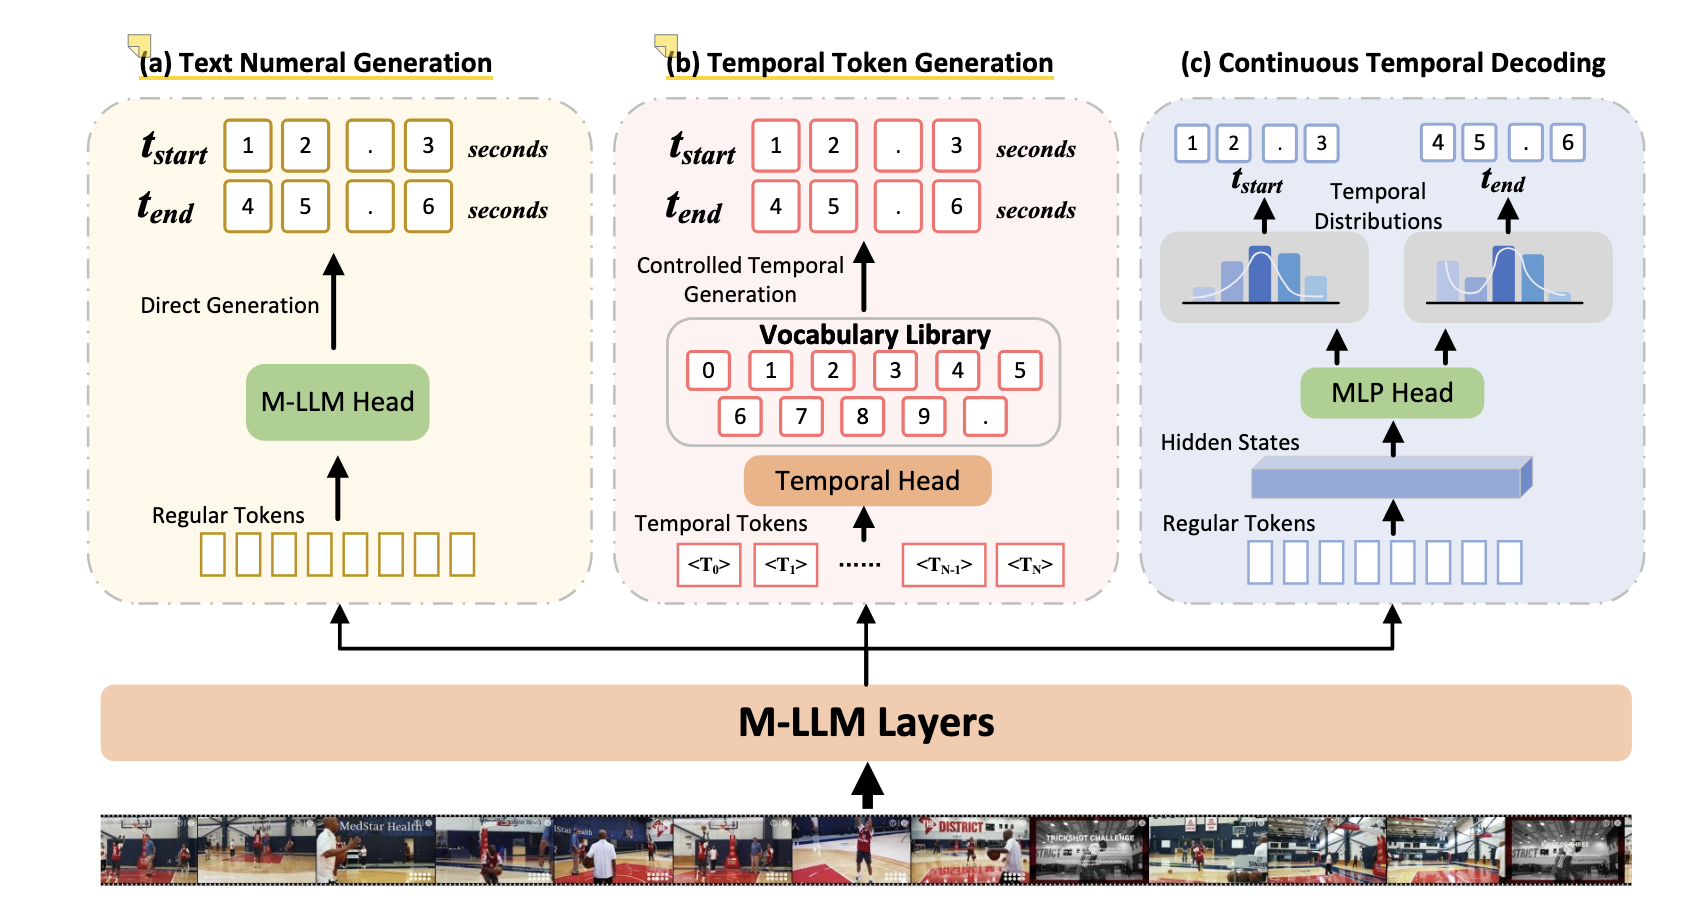
由上图可知,作者将前面视频到大模型这一部分都保持相同,在大模型生成隐藏向量h之后,才会分别进入三种不同的输出方式,这也是受控实验的设计。下面一一介绍三种输出方式的原理,不过在此之前,我想以文本数字生成这种方法为例,介绍一下本文中模型训练和测试的数据路径。
文本数字生成
训练过程:视频、查询、Ground Truth(GT)进入编码器或者tokenizer成为向量形式,将它们进行拼接,经过大模型之后,会生成一个h矩阵,这便是隐藏向量(因为GT也输入进来了,这个隐藏向量是完整的),它已经包含了我们输入的各种信息,接下来h进入到文本数字编码这个模块中,生成第k个token基于指令I、视频特征F、前k-1个GT token,然后当前token和第k个GT token存在损失,将所有token的损失取平均得到损失函数,进行反向传播更新模型。
测试过程:测试时没有正确答案,所以模型输出第k个token实际上是基于I、K、前面模型预测的k-1个token的,理论上每新生成一个token都要从头重新生成隐藏状态,实际上由KV cache避免重复计算。
第一个公式是文本数字生成的概率模型,说明了一个预测整体的概率是由每一个token的概率相乘得到的,而每一个token的概率生成也是基于之前的token的。将第一个公式做变形,也就是取负对数,就可以得到第二个公式,这就是损失函数,最小化损失函数的目标也就是为了加大得到GT的概率。
时间token编码
这里的时间token编码采用TRACE风格,首先是创建了时间词表以及时间专用输出头,时间词表长这样:<0> <1> … <9> <.>
第一个公式是说,在多事件情况下,第k个事件预测基于I、F、前k-1个事件,这是事件间的概率模型;而第二个公式则是表示了事件内部的概率模型,每一个事件显示在前面事件的基础上生成t,接着在t的基础上生成s,在它们的基础上再生成c,这样就生成了一个事件。这样做的是为了DVC任务,方便建模事件之间的联系。
连续时间解码
设计了一个专用token⟨TIME STAMP⟩来提取h表示,称作htime,假设我们设置33个anchor,那么算上开始和结束一共就会有66个anchor,将htime输入一个MLP先进行降维成66维,然后softmax得到概率分布,然后用如下公式加权平均即可(公式一是连续型积分,公式二是离散表示)得到时间表示。
三种方式对比
可以发现,前两种方式仍然主要依赖于让模型预测token与GT一致,举一个简单的例子,假如GT的开始事件是21,模型预测输出是19,还有一种预测输出是89,这两种输出哪一个离21更近?如果完全按照token一致的训练目标来看,也许不能够很好分别其中的时间差别。而第三种方式,连续时间解码,将时间重叠作为优化目标,因此可能更好一些。
性能对比
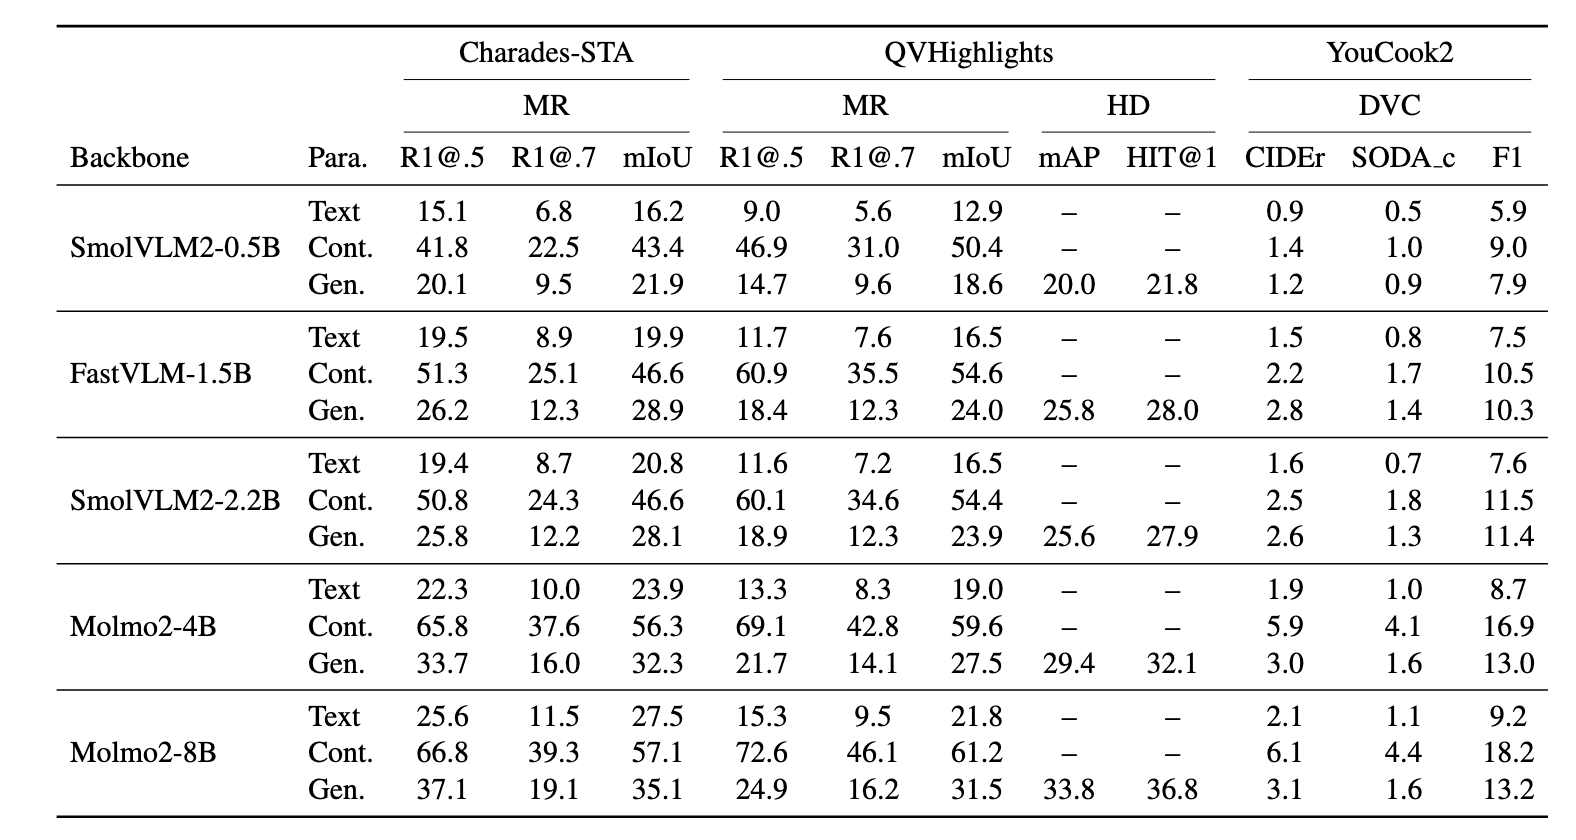
结果来看连续时间解码在效率以及各项性能指标上都大多超过其他方法。
一些思考
这篇文章从输出范式的角度进行受控实验,这种思路值得学习,无脑卷SOTA可能需要更多的训练资源和时间成本,应该多考虑考虑能不能够从其他角度另辟蹊径(虽然如果有足够的资源我也挺想无脑一点的)。
最近也在考虑怎么优化论文阅读博客的写作方式,或许之后会考虑不再按篇记录,而是将多篇论文中提取的观点和启发一同写在一篇文章里,毕竟也算过了最初学的那一段时间了。不过遇到非常值得读的文章还是会认真分享的。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
